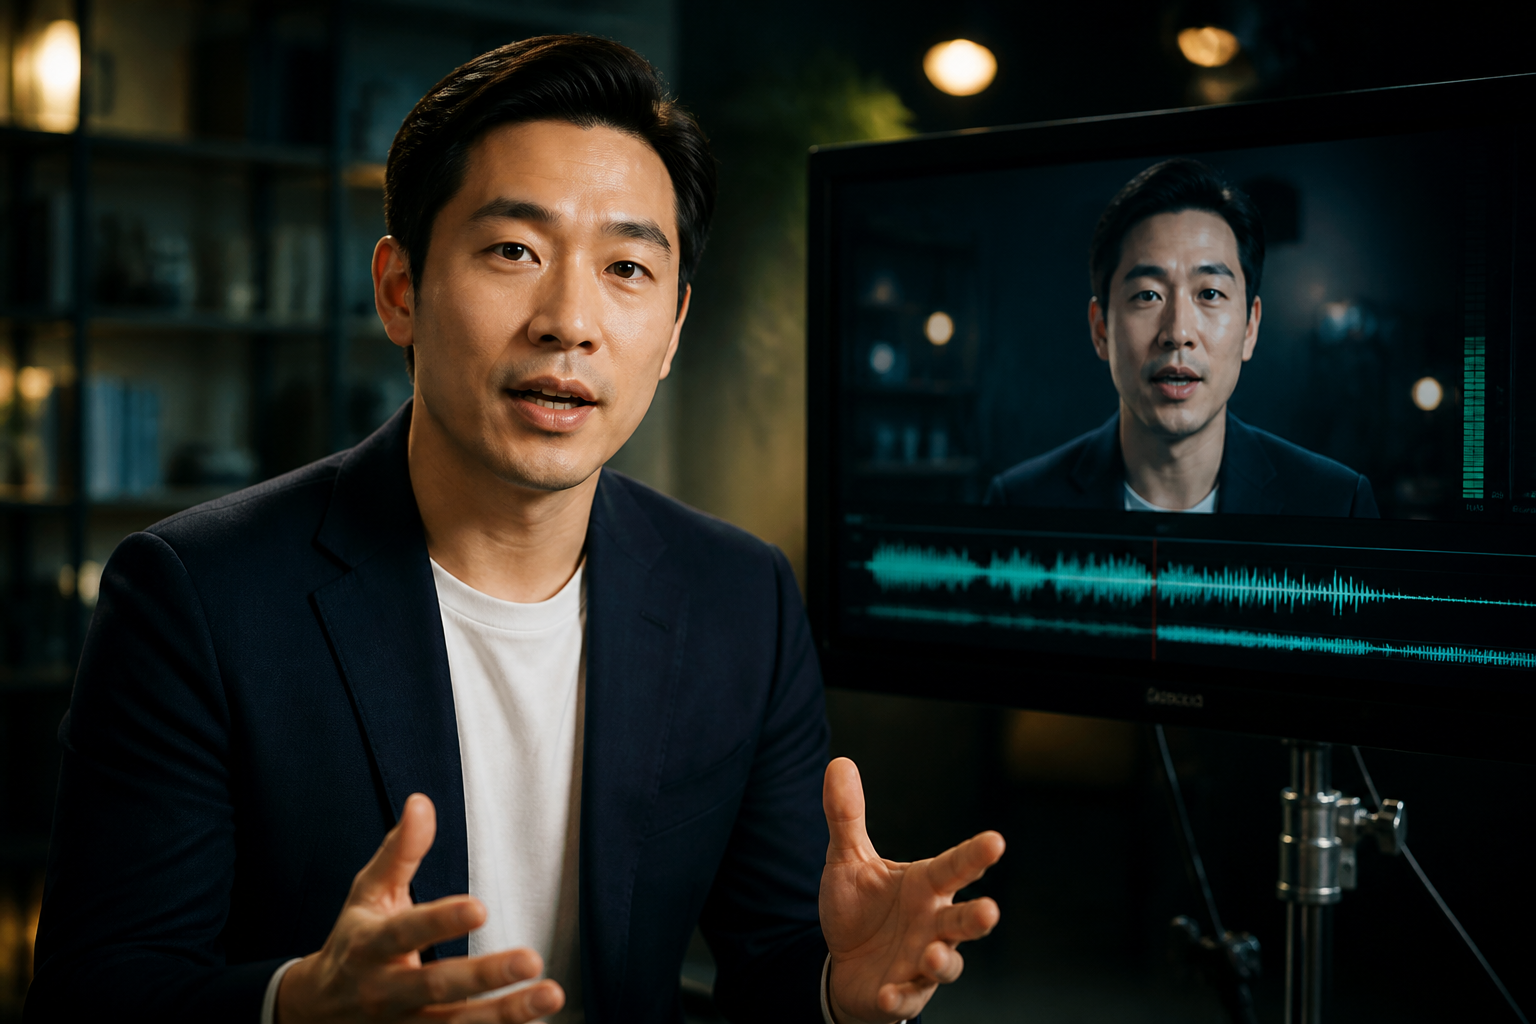
Команди навчання, підтримки й контенту, які шукають «Seedance talking-head», «Seedance 2.0 цифровий ведучий» або «Seedance AI lip-sync», зазвичай не страждають від браку обличчя — їм бракує збігу мовлення: зміна обличчя, лаг губ, збитий акцент діалогу, втрата ідентичності після cut на mid-shot. Цей гід вбудовує Seedance, Seedance 2.0 і Seedance 2.5 у workflow talking-head — від якорів обличчя до приймання lip-sync — щоб менше було «чути, про що мова, але не схоже, що говорить та сама людина».
Пов’язані розділи: Seedance 2.0 · Seedance 2.5 · AI-генератор відео · Гід із синхронізації аудіо · Що таке Seedance
Чому «Seedance talking-head» — запит із високою частотою
Атмосферний ролик може мовчати; розбір курсу, продуктовий talking-head, FAQ підтримки й тезис бренду мають мати «губи й слова в одному такті». Режисерський контроль Seedance 2.0, мультимодальні референси та нативна синхронізація аудіо й відео дають змогу записати talking-head як виконуваний spec: те саме обличчя, та сама репліка, той самий голосовий трек — замість картинки спочатку й жорсткого VO в постпродакшені. Перетворення пошукового наміру на «lip-sync до приймання» піднімає прохідність фіналу під запитами Seedance 2.0 / Seedance 2.5 сильніше, ніж порожнє «цифровий ведучий виглядає реалістично».
- Ідентичність до фіксації: обличчя, зачіска, одяг і світло сцени мають чекпоінти між кадрами
- Діалог до нарізки: один тезис ріжте на короткі знімальні фрази — уникайте монологу на одному подиху, який розмазує губи
- Чіткий шлях апгрейду: спочатку зафіксуйте 6–10-секундний шаблон talking-head на 2.0, довший безперервний діалог оцініть на Seedance 2.5
Talking-head vs чистий атмосферний A/V-ролик: не змішуйте ті самі промпти
Синхронізація аудіо й відео може обслуговувати кроки, unboxing і фоновий шум; talking-head додатково тримає «форму губ, наголос, паузу, безпечну зону субтитрів». Дописування до атмосферного промпту рядка «додай диктора» зазвичай закінчується майже нерухомим ротом або lip-sync на півтакта раніше звуку. Загальний спосіб письма sync — у гіді із синхронізації аудіо; цей текст пише лише про діалог on-camera.
- Обличчя спочатку: зафіксуйте референс ідентичності, потім пишіть діалог — не змінюйте обличчя на кожну репліку
- Фрази короткі: одне–два речення на кадр, посередині півтакта дихання, щоб губи встигли зійтися
- Камера стабільна: головний talking-head — locked medium close-up або micro-push; уникайте різкого whip, який рве форму губ
- Місце під субтитри: груди й нижня третина кадру — субтитрам; жести не повинні закривати рот
Seedance 2.0 talking-head: три шари написання
Шар 1: якорі обличчя й сцени (обов’язково)
Відкривайте кожен промпт, повторюючи ті самі ідентифікатори: зачіска й колір волосся, риси й віковий діапазон, одяг, напрямок key light, стіна фону / письмовий стіл. Без якірних рядків Seedance 2.0 може в кожній репліці видавати «майже той самий тип ведучого, але інше обличчя». Запишіть референсний портрет як копійований префікс. Щоб утримувати зовнішній вигляд між кадрами, див. гід з узгодженості персонажа.
Шар 2: обов’язок діалогу й ритм губ (наполегливо рекомендовано)
- Вкажіть обов’язок цього кадру: привітання / один тезис / назва продукту / заклик до дії (лише одна головна репліка за раз)
- Напишіть ритм діалогу: паузи, наголошені слова, чи дивиться в об’єктив; заборона довгої промови в одному кадрі
- Нехай камера служить губам: головний locked medium close-up, cut на close-up продукту й повернення до того самого обличчя (див. гід із руху камери)
Шар 3: голосовий трек і специфікація поставки (must-have talking-head)
Задайте один чистий голосовий трек усього talking-head (припустимий дуже легкий bed) — не змінюйте реверб на кожну репліку. Нативна sync Seedance підходить, щоб вирівняти відкриття/закриття губ зі складами; коли потрібен ambient, додавайте лише короткі SFX, які не перекривають голос. Також уніфікуйте кадр (лекція landscape 16:9, вертикальний feed — окремий шаблон) і 4–8 с на кадр, щоб приймати lip-sync по реченнях.
Повторюваний workflow Seedance talking-head (6 кроків)
- Напишіть скрипт talking-head: кожна репліка — коротка фраза (приблизно 8–12 слів, еквівалент 12–18 знаків), один інформаційний пункт на речення
- Зафіксуйте префікс якорів обличчя (референсний портрет + зачіска/одяг + світло сцени) — усі кадри його ділять
- На Seedance 2.0 (або Fast) спочатку проженіть ескіз першої репліки й підтвердіть відкриття/закриття губ
- Генеруйте речення за реченням: у кожному кадрі змінюйте лише «текст діалогу + мікровираз», ніколи обличчя й сцену
- Проженіть чекліст приймання lip-sync: чи йде відкриття за складом, чи немає зміни обличчя, чи зона субтитрів не закриває рот
- Після стабілізації шаблону батчте FAQ; коли потрібен довший безперервний діалог — upgrade на Seedance 2.5
Чекліст приймання talking-head
- Це все ще те саме обличчя (зачіска, віковість, makeup без стрибків)?
- Відкриття/закриття губ синхронізується з наголошеними словами — без порожнього рота чи лагу?
- Погляд більшу частину часу в об’єктив, а не дрейфує за кадр?
- Голос розбірливий, а bed не перекриває діалог?
- Після cut на close-up продукту й повернення — той самий ведучий і те саме світло сцени?
Чотири високопродуктивні шаблони Seedance 2.0 talking-head
- Відкриття курсу: «Той самий чорноволосий викладач, бежевий светр, світлий стіл; medium close-up в об’єктив каже «сьогодні лише одна формула»; locked із micro-push, чистий голос, легкий bed, landscape 16:9, 6 с.»
- Продуктовий talking-head із назвою: «Ті самі срібні навушники входять у кадр; ведучий on-camera вимовляє ім’я бренду, cut на close-up продукту, повернення до того самого обличчя; тепле комерційне світло, короткий ident, вертикаль можна здати окремо.»
- FAQ підтримки: «Той самий образ підтримки, гарнітура й бейдж; одне запитання, одна відповідь, посередині півтакта; locked mid-shot, без перебільшеної міміки — зручно батчити заміну діалогу.»
- Закриття тезису бренду: «Той самий ведучий біля вікна; півсекунди порожнього кадру, потім вхід у кадр зі слоганом, губи сідають на останнє слово; легкий акцент sound ident, landscape, 5–7 с.»
Як вибрати стратегію talking-head за сценарієм?
- Навчання / курс: після фіксації обличчя виходьте речення за реченням; B-roll розділів стикуйте з гідом для авторів YouTube
- Ecommerce talking-head / live selling: якорі продукту й обличчя запишіть окремо й жорстко; можна стикувати з гідом з ecommerce-відео продукту
- Talking-head тезису бренду: слоган лише на закриваючому кадрі, раніше менше мовлення; структуру головного ролика див. у гіді з брендового ролика
- Потрібен довший безперервний діалог за один take: спочатку перевірте lip-sync однієї репліки на 2.0, потім оцініть Seedance 2.5, щоб зменшити відчуття splice фраз
Коли довгий діалог talking-head потребує Seedance 2.5?
Більшість одиночних реплік 4–8 с, батчів FAQ і відкриттів курсу вигідніші на Seedance 2.0 (включно з тестом lip-sync на Fast і батчем заміни фраз на Mini). Перенесіть перевірений шаблон talking-head на Seedance 2.5, коли потрібно майже 15–30 с безперервної мови, паралельні референси (портрет + референсне аудіо talking-head + сцена) або менша вартість «cut на кожне речення → знову вирівняти губи».
- Один take потребує довшого безперервного діалогу — посередині не можна різати й змінювати обличчя
- Головний кадр лекції одночасно обмежений стилем картинки + голосовим референсом + точністю lip-sync
- Головний ролик бренду / курсу потребує вищої роздільності й менше видимих точок монтажу
Відмінності версій див. у порівнянні 2.0 vs 2.5 і на сторінці продукту Seedance 2.5. Принцип: спочатку проженіть якорі обличчя й lip-sync однієї репліки на 2.0, потім upgrade під тривалість і безперервність — не спалюйте 2.5 на кожному експерименті talking-head.
Типові причини провалу talking-head
- Немає якорів обличчя — кожна репліка переписує зовнішність і призводить до зміни обличчя
- Уся промова в одному кадрі, губи не встигають за складами
- Різка камера або часті close-up рвуть форму губ рухом
- Bed надто гучний, реверб надто важкий — діалог не розібрати, lip-sync важче прийняти
- Атмосферний промпт із дописаним «додай диктора» — рот майже нерухомий
Додаткове читання
- Workflow для початківців: Як користуватися Seedance 2.0
- Глибоке занурення в промпти: Гід із prompt engineering
- Text-to-video на кадри діалогу: Гід із text-to-video
- Image-to-video на портрет: Гід із image-to-video
Висновок
Використовувати Seedance 2.0 на talking-head і цифрового ведучого — це не «обличчя більше схоже на зірку», а багаторазова виробнича лінія діалогу: якорі обличчя записані жорстко, одне речення на кадр, губи й наголос до приймання. Спочатку зафіксуйте 6–10-секундний шаблон talking-head на Seedance 2.0, потім переходьте на Seedance 2.5, коли потрібна довша безперервна мова. Коли готові — відкрийте Seedance 2.0 і почніть наступний AI talking-head з однієї короткої репліки.