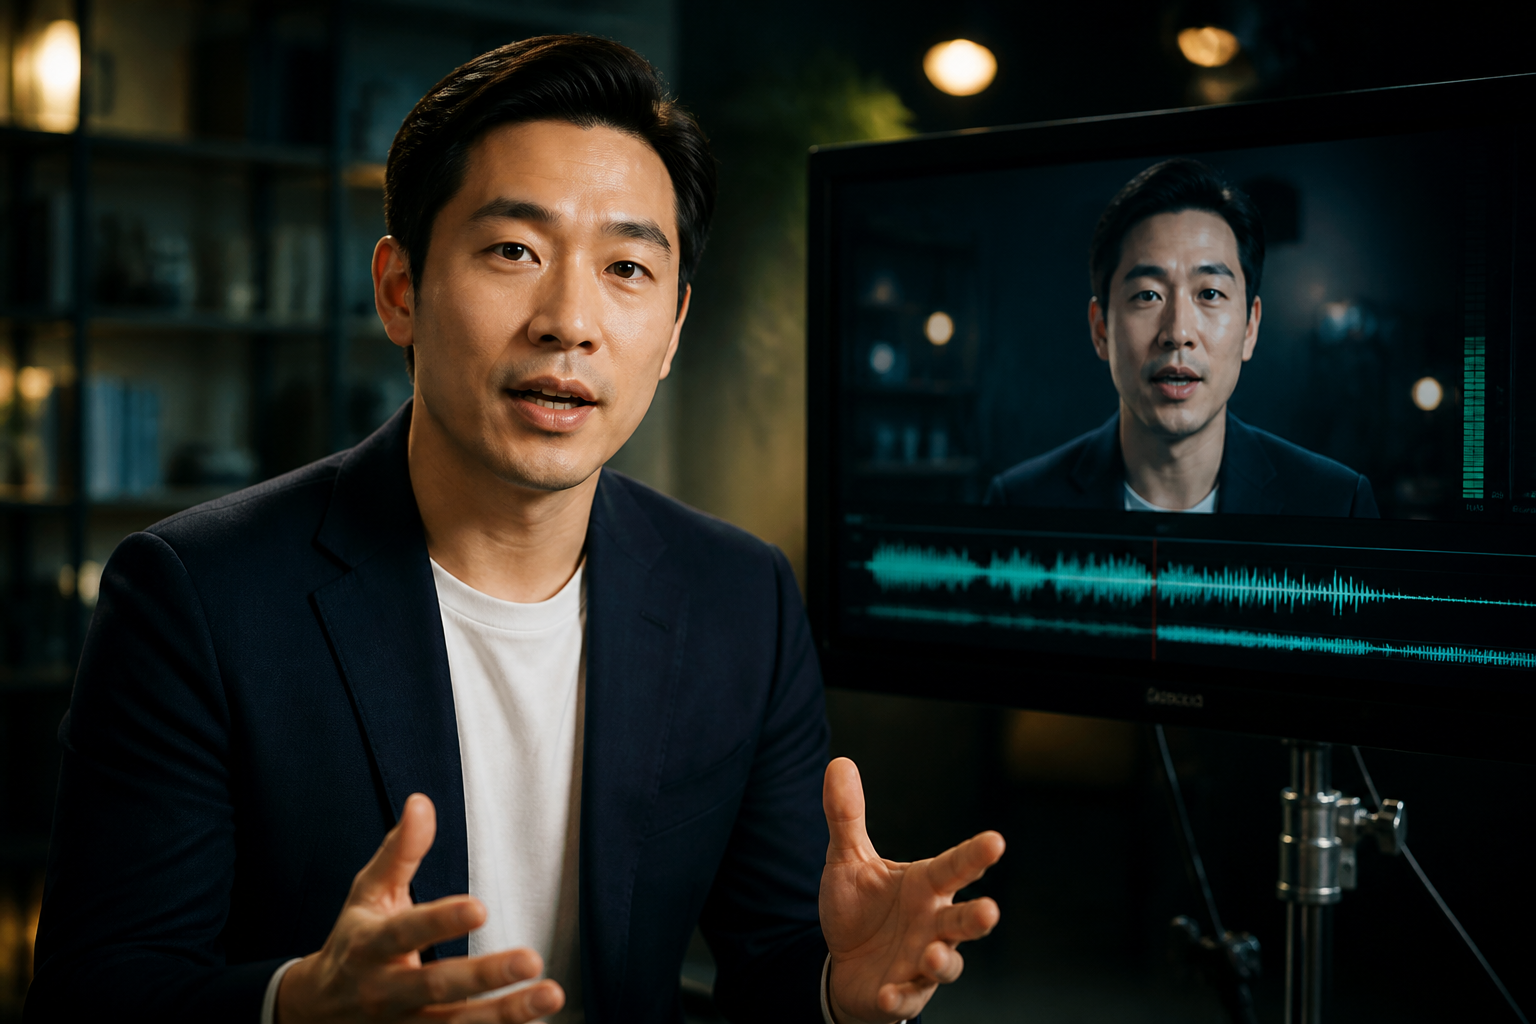
Teams, die nach «Seedance Talking-Head», «Seedance 2.0 Avatar» oder «Seedance AI Lip-Sync» suchen—Training, Support und Content—fehlt selten ein Gesicht: der Talking-Head klebt nicht. Face-Swap, Lippen im Verzug, Dialogakzente versetzt, Identität weg beim Mid-Shot. Dieser Guide setzt Seedance, Seedance 2.0 und Seedance 2.5 in einen Talking-Head-Workflow—von Gesichts-Ankern zur Lippen-Checkliste—für weniger «man versteht die Worte, glaubt aber nicht, dass dieselbe Person spricht».
Verwandte Einstiege: Seedance 2.0 · Seedance 2.5 · KI-Videogenerator · Audio-Sync-Guide · Was ist Seedance
Warum «Seedance Talking-Head» eine High-Frequency-Suchanfrage ist
Ein Stimmungsfilm darf schweigen; Kurs-Erklärungen, Produkt-Talking-Head, Support-FAQ und Marken-Claims brauchen «Mund und Wort auf demselben Beat». Die Regie-Kontrolle von Seedance 2.0, multimodale Referenzen und native Audio-Video-Sync lassen den Talking-Head als ausführbare Spec schreiben: dasselbe Gesicht, dieselbe Replik, dieselbe Vocal-Spur—nicht erst Bild, dann Voice-over in der Post kleben. Suchintention in «abnahmefähigen Lip-Sync» zu übersetzen hebt die Schnitt-Durchlaufquote unter Seedance 2.0 / Seedance 2.5 mehr als «hyperrealer Avatar» zu rufen.
- Identität sperrbar: Gesicht, Frisur, Kostüm und Szenenlicht haben Shot-übergreifende Checkpoints
- Dialog zerlegbar: ein Claim zerfällt in kurze, filmbare Sätze, damit ein Atemzug den Lip-Sync nicht verwischt
- Klarer Upgrade-Pfad: 2.0 sperrt zuerst ein 6–10-s-Talking-Head-Template, dann Seedance 2.5 für längeren fortlaufenden Dialog bewerten
Talking-Head-Schnitt vs. reiner Audio-Stimmungsfilm: dieselben Prompts nicht mischen
Audio-Video-Sync kann Schritte, Unbox und Room-Tone bedienen; der Talking-Head muss zusätzlich «Lippenform, Akzente, Pausen, Untertitel-Safe-Zone» führen. An einen Stimmungs-Prompt einfach «Voice-over dazu» zu hängen scheitert oft: Mund fast still, oder Lippen eine halbe Note vor dem Audio. Die allgemeine Sync-Schreibweise bleibt im Audio-Sync-Guide; dieser Artikel behandelt nur On-Screen-Dialog.
- Gesicht zuerst: Identitätsreferenz zuerst sperren, dann Dialog schreiben—kein neues Gesicht pro Satz
- Sätze kurz: ein bis zwei Sätze pro Shot, eine halbe Note Atem in der Mitte, damit Lip-Sync alignen kann
- Kamera ruhig: Talking-Head-Master als festes Mid-Close oder Mikro-Push, keine heftigen Whip-Pans, die die Lippenform unterbrechen
- Luft für Untertitel: Brust und unteres Drittel des Frames für Untertitel, Gesten dürfen den Mund nicht verdecken
Seedance 2.0 Talking-Head: drei Schichten Schreiben
Schicht 1: Gesichts- und Szenen-Anker (pflicht)
Öffnen Sie jeden Prompt, indem Sie denselben Identifikator-Satz wiederholen: Frisur und Haarfarbe, Gesichtszüge und Altersband, Kostüm, Key-Light-Richtung, Hintergrundwand / Schreibtisch. Ohne Ankerzeile kann Seedance 2.0 «fühlt sich wie derselbe Presenter-Typ an, aber ein anderes Gesicht» pro Satz liefern. Schreiben Sie das Referenzporträt als kopierbares Präfix. Damit das Aussehen Shot-übergreifend hält, siehe den Charakterkonsistenz-Guide.
Schicht 2: Dialog-Aufgabe und Lippenrhythmus (stark empfohlen)
- Nennen Sie die Aufgabe dieses Shots: Begrüßung / ein Claim / Produktnennung / Call-to-Action (nur eine primäre Phrase)
- Schreiben Sie den Dialogrhythmus: markieren Sie Pausen, Akzentwörter, Blick in die Kamera oder nicht; kein langer Vortrag im selben Shot
- Kamera dient dem Lip-Sync: Master festes Mid-Close, Cut zum Produkt-Close-up, zurück zum selben Gesicht (Bewegungsdetails im Kamerabewegungs-Guide)
Schicht 3: Vocal-Spur und Delivery-Specs (Talking-Head-Pflicht)
Legen Sie eine saubere Vocal-Spur für den ganzen Talking-Head fest (sehr leichter Bed erlaubt) und wechseln Sie nicht die Hall-Charakteristik pro Satz. Native Sync von Seedance ist dafür gebaut, Lippenöffnung an Silben zu alignen; Umgebungsakzente nur als kurze SFX—decken Sie die Stimme nicht zu. Vereinheitlichen Sie außerdem das Bildformat (Erklärung Querformat 16:9, Feed-Hochformat in ein eigenes Template), 4–8 s pro Shot, damit Reviews den Lip-Sync satzweise abnehmen.
Ein reproduzierbarer Seedance-Talking-Head-Workflow (6 Schritte)
- Schreiben Sie das Talking-Head-Skript: jeder Satz höchstens ~12–18 chinesische Zeichen (oder ein kurzer Satz in der Zielsprache), ein Informationspunkt pro Satz
- Frieren Sie das Gesichts-Anker-Präfix ein (Porträt-Referenz + Frisur/Kostüm + Szenenlicht), geteilt von allen Shots
- Fahren Sie den ersten Talking-Head-Entwurf zuerst auf Seedance 2.0 (oder Fast) durch, um Lippenöffnung zu bestätigen
- Satzweise generieren: ändern Sie nur «Dialogtext + Mikroexpression», nicht Gesicht und Szene
- Prüfen Sie an der Lippen-Checkliste: folgt die Öffnung den Silben, Face-Swap, verdeckt die Untertitel-Zone den Mund
- Nach stabilem Template FAQ in Batches; auf Seedance 2.5 upgraden, wenn längerer fortlaufender Dialog nötig ist
Abnahme-Checkliste für den Talking-Head-Schnitt
- Ist es noch dasselbe Gesicht (Frisur, Altersgefühl, Makeup/Kostüm ohne Sprung)?
- Ist die Lippenöffnung mit den Akzentwörtern sync, ohne leeren Mund oder offensichtlichen Verzug?
- Geht der Blick die meiste Zeit in die Kamera, statt zu einem belanglosen Off-Frame-Punkt?
- Ist die Stimme klar verständlich, deckt der Bed den Dialog nicht zu?
- Nach Cut zum Produkt-Close-up und zurück: noch derselbe Presenter, dasselbe Szenenlicht?
Vier hochverfügbare Seedance-2.0-Talking-Head-Templates
- Kurs-Opening: «Derselbe schwarzhaarige Dozent, beiger Pullover, heller Schreibtisch; Mid-Close, Blick in die Kamera, sagt «heute nur eine Formel»; feste Kamera Mikro-Push, klare Stimme, leichter Bed, Querformat 16:9, 6 s.»
- Produkt-Talking-Head mit Nennung: «Dieselben silbernen Kopfhörer im Bild; Presenter sagt den Markennamen, Cut zum Produkt-Close-up, zurück zum selben Gesicht; warmes kommerzielles Licht, kurzes Ident, Hochformat in eigenem Template.»
- Support-FAQ: «Dieselbe Support-Figur, Headset und Badge; eine Frage, eine Antwort, eine halbe Note dazwischen; festes Mid-Shot, keine übertriebenen Mimik, damit Dialog in Batches ersetzt werden kann.»
- Marken-Claim-Close: «Derselbe Presenter am Fenster; halbe Sekunde Leerplan, dann Eintritt und Slogan, Lip-Sync landet auf dem letzten Wort; Ident als kurzer Akzent, Querformat, 5–7 s.»
Wie wählt man die Talking-Head-Strategie nach Szenario?
- Training / Kurs: Gesicht gesperrt, dann satzweise on camera; Kapitel-B-roll kann an den YouTube-Creator-Guide anschließen
- E-Commerce-Talking-Head / Live-Shopping: Produkt-Anker und Gesicht getrennt festschreiben; an den E-Commerce-Produktvideo-Guide anschließen
- Marken-Claim-Talking-Head: Slogan nur im Close-Shot, davor wenig sprechen; Hauptfilm-Struktur im Markenwerbespot-Guide
- Längerer fortlaufender Dialog in einer Aufnahme nötig: Lip-Sync zuerst satzweise auf 2.0 validieren, dann Seedance 2.5 bewerten, um das Assemblage-Gefühl zu reduzieren
Wann braucht langer Talking-Head-Dialog Seedance 2.5?
Die meisten Einzel-Sätze 4–8 s, FAQ-Batches und Kurs-Openings passen besser zu Seedance 2.0 (Lip-Sync-Tests mit Fast und Satz-Ersatz-Batches mit Mini inklusive). Verschieben Sie ein validiertes Talking-Head-Template nach Seedance 2.5, wenn Sie fortlaufendes Sprechen nahe 15–30 s brauchen, multimodale Referenzen parallel (Porträt + Talking-Head-Audio-Referenz + Szene), oder weniger Kosten «ein Satz, ein Cut → dann Lippen neu alignen».
- Eine Aufnahme braucht längeren fortlaufenden Dialog, ohne Cut oder Face-Swap in der Mitte
- Ein Erklär-Master-Shot gleichzeitig von Bildlook + Vocal-Referenz + Lippenpräzision constrained
- Marken-/Kurs-Hauptfilm verlangt höhere Auflösung und weniger sichtbare Schnittpunkte
Versionsunterschiede siehe den 2.0-vs-2.5-Vergleich und die Seedance-2.5-Produktseite. Regel: Gesichts-Anker und satzweisen Lip-Sync zuerst auf 2.0 durchfahren, dann für Dauer und Kontinuität upgraden—verbrennen Sie 2.5 nicht für jedes Talking-Head-Experiment.
Häufige Talking-Head-Fehlerursachen
- Keine Gesichts-Anker, Aussehen pro Satz neu schreiben führt zu Face-Swap
- Einen ganzen Vortrag in einen Shot stopfen, Lip-Sync kommt den Silben nicht hinterher
- Heftige Kamerabewegung oder häufige Close-ups, Lippenform wird von der Aktion unterbrochen
- Bed zu laut, Hall zu schwer: Dialog unverständlich, Lip-Sync noch schwerer abzunehmen
- An einen Stimmungs-Prompt «Voice-over dazu» hängen, der Mund bewegt sich kaum
Weiterlesen
- Anfänger-Workflow: So nutzen Sie Seedance 2.0
- Prompt-Tiefenlage: Prompt-Engineering-Guide
- Text-zu-Video für Dialog-Shots: Text-zu-Video-Guide
- Bild-zu-Video für Porträt: Bild-zu-Video-Guide
Fazit
Seedance 2.0 für Talking-Head und Avatar zu nutzen heißt nicht «Gesicht starähnlicher», sondern eine wiederverwendbare Dialog-Produktionslinie: Gesichts-Anker eingefroren, ein Satz pro Shot, Lip-Sync und Akzente abnahmefähig. Sperren Sie das 6–10-s-Talking-Head-Template auf Seedance 2.0, dann upgraden Sie auf Seedance 2.5, wenn längeres fortlaufendes Sprechen nötig ist. Wenn Sie bereit sind, öffnen Sie Seedance 2.0 und starten Sie Ihren nächsten KI-Talking-Head von einer kurzen Replik.