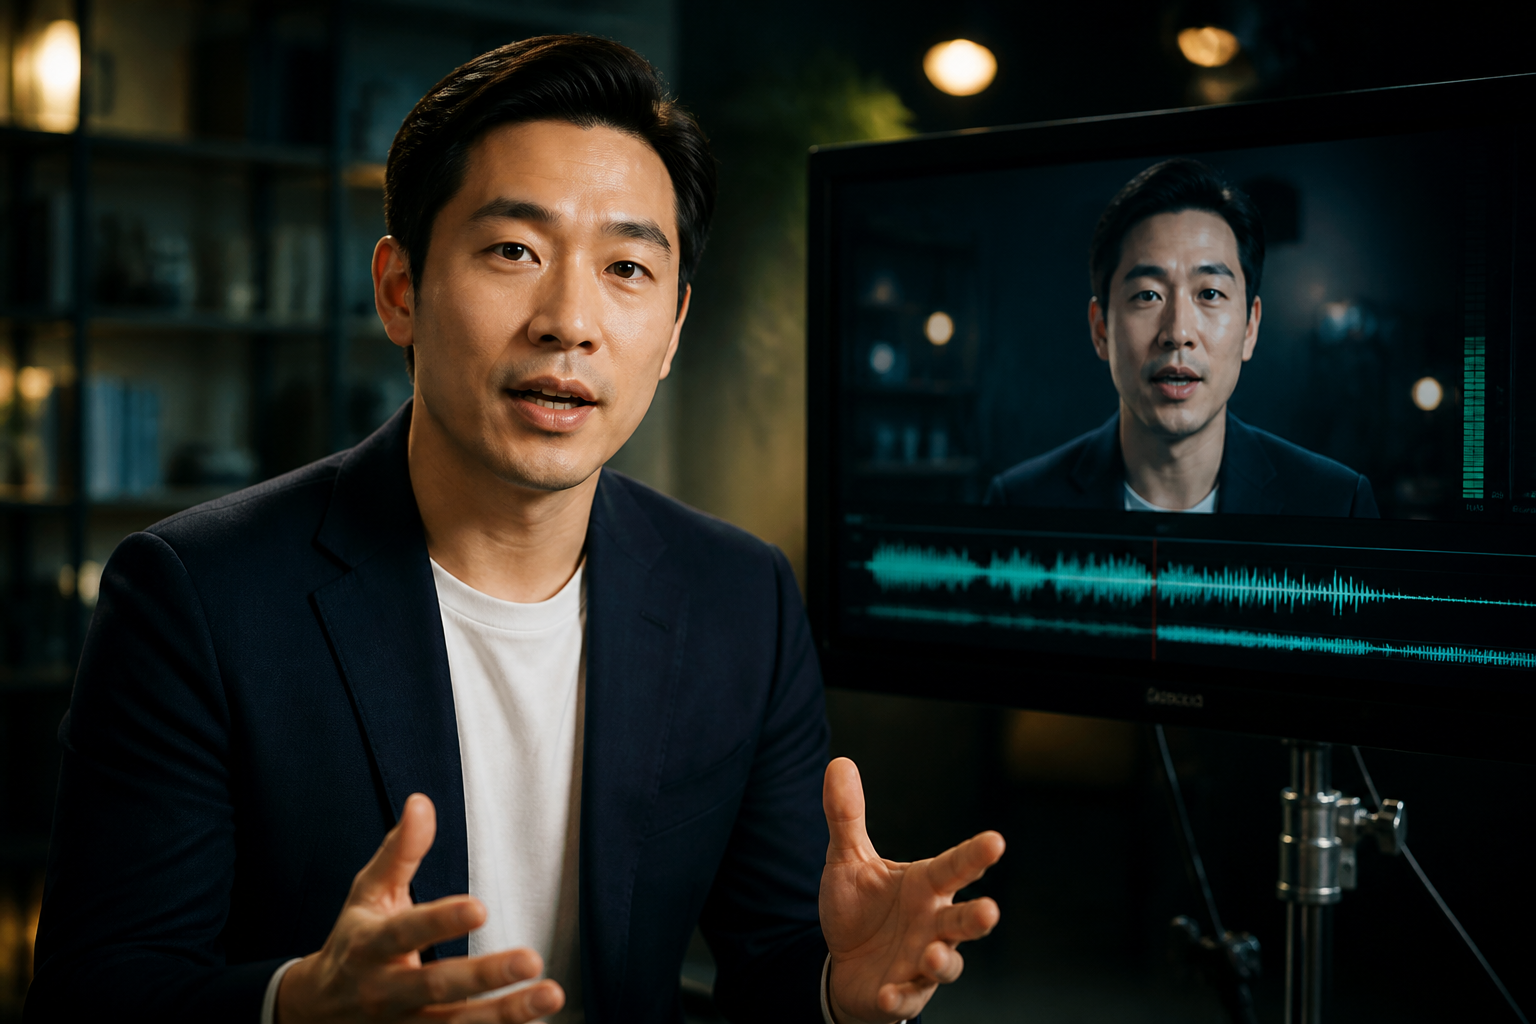
Quem busca «Seedance talking-head», «Seedance 2.0 avatar falante» ou «Seedance AI lip-sync»—times de treino, suporte e conteúdo—geralmente não falta um rosto: o talking-head não encaixa. Troca de cara, lábios atrasados, acentos de diálogo deslocados, identidade perdida no mid-shot. Este guia coloca Seedance, Seedance 2.0 e Seedance 2.5 numa cadeia de talking-head—das âncoras de rosto à checklist labial—para reduzir «dá para entender as palavras, mas não parece a mesma pessoa falando».
Entradas relacionadas: Seedance 2.0 · Seedance 2.5 · Gerador de vídeo IA · Guia de sincronia áudio-vídeo · O que é Seedance
Por que «Seedance talking-head» é uma busca de alta frequência?
Um filme de atmosfera pode ficar em silêncio; aula, talking-head de produto, FAQ de suporte ou afirmação de marca exigem que «boca e palavra caiam no mesmo tempo». O controle de nível de direção do Seedance 2.0, referências multimodais e sincronia nativa áudio-vídeo permitem escrever o talking-head como spec executável: o mesmo rosto, a mesma fala, a mesma trilha vocal—não imagem primeiro e locução colada depois. Transformar a intenção de busca em «lip-sync aceitável» eleva a taxa de aprovação do corte sob Seedance 2.0 / Seedance 2.5 mais do que gritar «avatar hiper-realista».
- Identidade travável: rosto, cabelo, figurino e luz de cena têm checkpoints entre planos
- Diálogo quebrável: uma afirmação se parte em frases curtas filmáveis, para evitar um só fôlego que embaralha o lip-sync
- Caminho de upgrade claro: 2.0 trava primeiro um template talking-head de 6–10 s, depois avalie Seedance 2.5 para um diálogo contínuo mais longo
Corte talking-head vs filme de atmosfera áudio-vídeo: não misture o mesmo set de prompts
A sincronia áudio-vídeo pode servir passos, unbox e ruído de fundo; o talking-head ainda precisa gerir «forma dos lábios, acentos, pausas, zona segura de legendas». Colar «põe uma locução» num prompt de atmosfera costuma falhar: boca quase parada, ou lábios meio tempo à frente do áudio. A escrita de sync geral continua no guia de sincronia áudio-vídeo; este artigo cobre só diálogo em câmera.
- Rosto primeiro: trave a referência de identidade antes, depois escreva o diálogo—não troque de cara a cada frase
- Frases curtas: uma a duas frases por plano, meio tempo de respiração no meio, para alinhar o lip-sync
- Câmera estável: plano mestre talking-head em mid-close travado ou micro-push, evite whip-pans violentos que interrompem a forma dos lábios
- Ar para legendas: peito e terço inferior do quadro para legendas, gestos não devem tapar a boca
Seedance 2.0 talking-head: três camadas de escrita
Camada 1: âncoras de rosto e cena (obrigatório)
Abra cada prompt repetindo o mesmo set de identificadores: corte e cor de cabelo, traços e faixa etária, figurino, direção da luz-chave, parede / mesa de fundo. Sem linhas de âncora, o Seedance 2.0 pode entregar «parece o mesmo tipo de apresentador, mas outro rosto» a cada frase. Escreva o retrato de referência como prefixo copiável. Para segurar a aparência entre planos, veja o guia de consistência de personagem.
Camada 2: dever do diálogo e ritmo labial (fortemente recomendado)
- Declare o dever deste plano: saudação de abertura / uma afirmação / nomeação do produto / chamada para ação (só uma frase primária por vez)
- Escreva o ritmo de diálogo: marque pausas, palavras acentuadas, olhar para a câmera ou não; proibido empilhar um discurso longo no mesmo plano
- Deixe a câmera servir ao lip-sync: mestre mid-close travado, corte para close de produto e volta ao mesmo rosto (detalhes de movimento no guia de movimento de câmera)
Camada 3: trilha vocal e specs de entrega (indispensável no talking-head)
Fixe uma trilha vocal limpa para o talking-head inteiro (uma cama bem leve é ok) e não mude a reverberação a cada frase. A sincronia nativa do Seedance serve para alinhar a abertura dos lábios às sílabas; para acentos de ambiente, some só SFX curtos—não cubra a voz. Unifique também a proporção (aula em paisagem 16:9, feed vertical em outro template), 4–8 s por plano, para aceitar o lip-sync frase a frase.
Um fluxo Seedance talking-head reproduzível (6 passos)
- Escreva o roteiro talking-head: cada frase não passa de ~12–18 caracteres chineses (ou uma frase curta no idioma de destino), um ponto de informação por frase
- Congele o prefixo de âncoras de rosto (referência de retrato + cabelo/figurino + luz de cena), compartilhado por todos os planos
- Passe primeiro o rascunho da primeira frase no Seedance 2.0 (ou Fast) para confirmar a abertura dos lábios
- Gere frase a frase: mude só «texto de diálogo + microexpressão», não o rosto nem a cena
- Confira na checklist labial: a abertura segue as sílabas, houve troca de cara, a zona de legendas tapa a boca
- Com o template estável, faça batch das FAQ; migre para o Seedance 2.5 quando um diálogo contínuo mais longo for necessário
Checklist de aceite do corte talking-head
- Ainda é o mesmo rosto (cabelo, senso de idade, maquiagem/figurino sem salto)?
- A abertura dos lábios está em sync com as palavras acentuadas, sem boca vazia nem atraso óbvio?
- O olhar está na câmera na maior parte do tempo, em vez de um ponto fora de quadro irrelevante?
- A voz está clara e inteligível, a cama não cobre o diálogo?
- Depois de um corte para close de produto e a volta, ainda é o mesmo apresentador, a mesma luz de cena?
Quatro templates Seedance 2.0 de talking-head de alto rendimento
- Abertura de aula: «Mesmo instrutor de cabelo preto, suéter bege, mesa clara; mid-close olhando para a câmera diz «hoje só uma fórmula»; câmera travada micro-push, voz clara, cama leve, paisagem 16:9, 6 s.»
- Talking-head de produto com nomeação: «Mesmos fones prateados em quadro; o apresentador diz o nome da marca, corte para close de produto, volta ao mesmo rosto; luz comercial quente, ident curto, vertical em outro template.»
- FAQ de suporte: «Mesma figura de suporte, fone e crachá; uma pergunta, uma resposta, meio tempo no meio; mid-shot travado, sem expressão exagerada, para substituir o diálogo em batch.»
- Fechamento de afirmação de marca: «Mesmo apresentador na janela; meio segundo de plano vazio depois entra e diz o slogan, lip-sync que pousa na última palavra; ident como acento curto, paisagem, 5–7 s.»
Como escolher a estratégia de talking-head segundo o cenário?
- Treino / aula: rosto travado, depois frase a frase em câmera; o B-roll de capítulo pode ligar ao guia para criadores YouTube
- Talking-head ecommerce / live shopping: âncoras de produto e de rosto escritas e travadas à parte; ligue ao guia de vídeo de produto ecommerce
- Talking-head de afirmação de marca: o slogan só no plano de fechamento, pouca fala antes; estrutura do filme principal no guia de filme de marca
- Precisa de um diálogo contínuo mais longo numa tomada: valide primeiro o lip-sync frase a frase no 2.0, depois avalie o Seedance 2.5 para reduzir a sensação de emenda
Quando um talking-head de diálogo longo precisa de Seedance 2.5?
A maioria das frases únicas de 4–8 s, batches de FAQ e aberturas de aula encaixa melhor no Seedance 2.0 (incluindo testes de lip-sync Fast e lotes de frases substitutas Mini). Mova um template talking-head validado para o Seedance 2.5 quando você precisa de fala contínua perto de 15–30 s, referências multimodais em paralelo (retrato + áudio talking-head de referência + cena), ou menos custo de «uma frase, um corte → depois realinhar os lábios».
- Uma tomada exige diálogo contínuo mais longo, sem corte nem troca de cara no meio
- Um plano mestre de explicação constrangido ao mesmo tempo por look da imagem + referência vocal + precisão labial
- O filme principal de marca / aula pede resolução mais alta e menos pontos de corte visíveis
Veja diferenças de versão na comparação 2.0 vs 2.5 e na página do produto Seedance 2.5. Regra: passe primeiro âncoras de rosto e lip-sync frase a frase no 2.0, depois faça upgrade por duração e continuidade—não gaste 2.5 em todo experimento de talking-head.
Causas comuns de falha no talking-head
- Sem âncoras de rosto, reescrever a aparência a cada frase leva à troca de cara
- Empilhar um discurso inteiro num só plano, o lip-sync não alcança as sílabas
- Movimento de câmera violento ou closes frequentes, a forma dos lábios é interrompida pela ação
- Cama alta demais, reverberação pesada demais: não se ouve o diálogo, ainda mais difícil aceitar o lip-sync
- Colar «põe uma locução» num prompt de atmosfera, a boca quase não se mexe
Para ir além
- Fluxo para iniciantes: Como usar o Seedance 2.0
- Aprofundamento de prompts: Guia de engenharia de prompts
- Texto para vídeo para travar planos de diálogo: Guia texto para vídeo
- Imagem para vídeo para complementar o retrato: Guia de imagem para vídeo
Conclusão
Usar o Seedance 2.0 em talking-head e avatar falante não é «rosto mais de celebridade»: é uma linha de produção de diálogo reutilizável—âncoras de rosto congeladas, uma frase por plano, lip-sync e acentos aceitáveis. Trave o template talking-head de 6–10 s no Seedance 2.0, depois migre para o Seedance 2.5 quando uma fala contínua mais longa for necessária. Quando você estiver pronto, abra o Seedance 2.0 e comece o próximo talking-head IA a partir de uma fala curta.