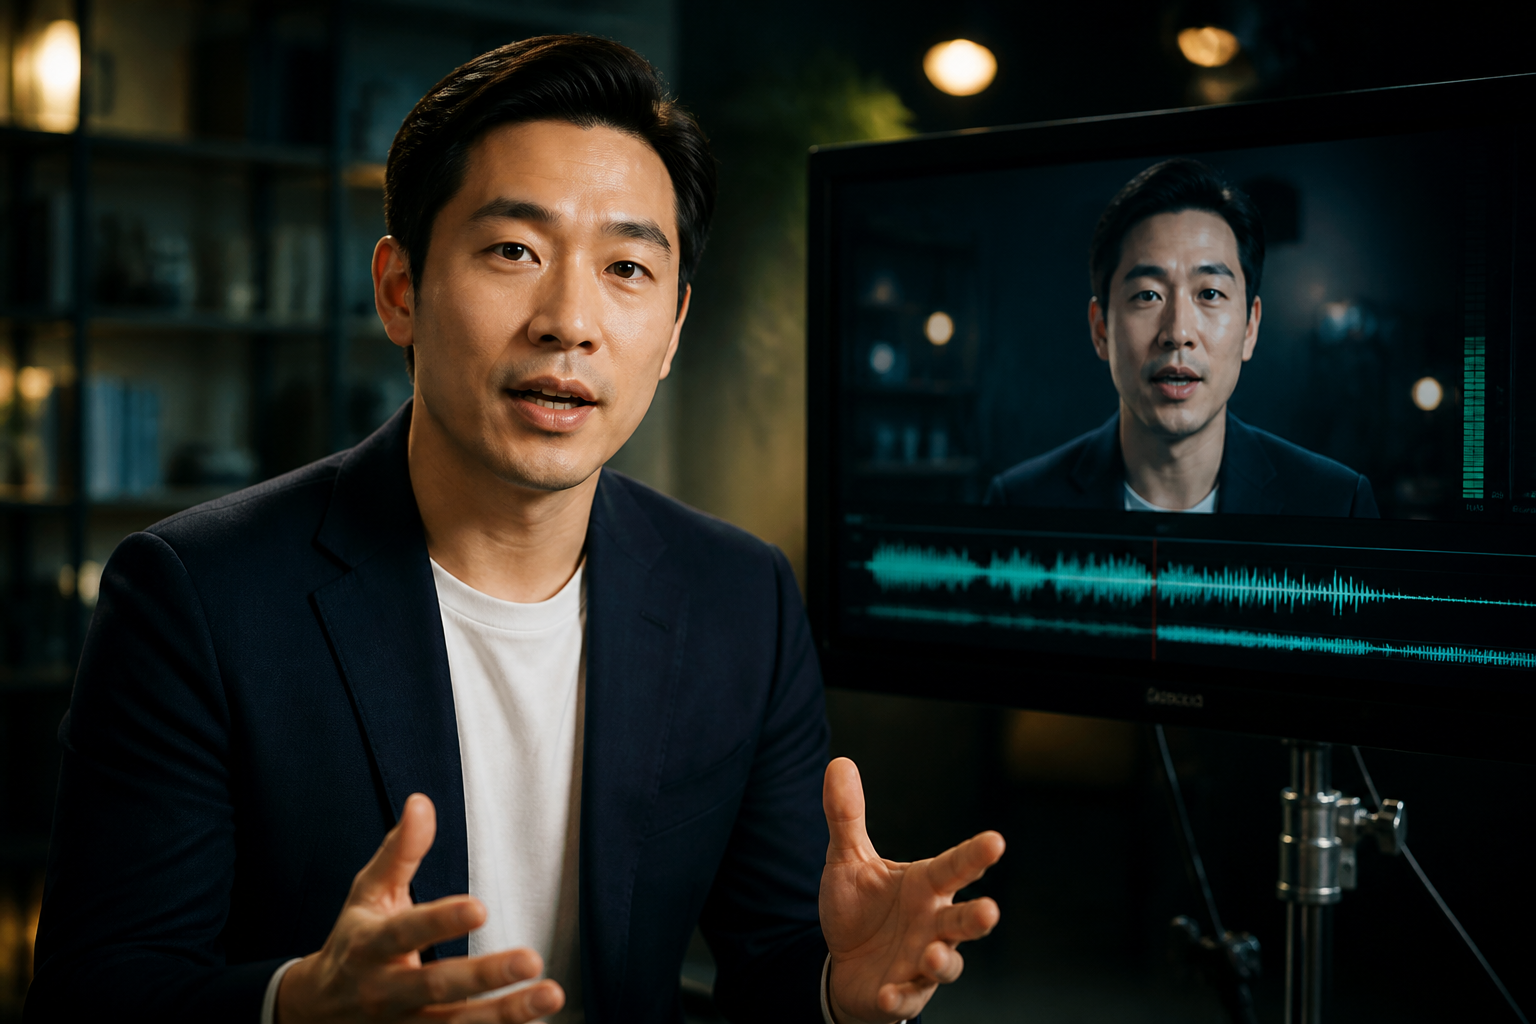
Los equipos de formación, soporte y contenidos que buscan «Seedance talking-head», «Seedance 2.0 humano digital» o «Seedance AI lip-sync» no suelen carecer de un rostro—les falta un talking-head que encaje: cambio de cara, labios atrasados, acento de diálogo mal colocado, identidad perdida en cuanto cortas a un plano medio. Esta guía sitúa Seedance, Seedance 2.0 y Seedance 2.5 en un flujo talking-head—de anclas de rostro al QA de lip-sync—para reducir «se oye, pero no parece la misma persona hablando».
Entradas relacionadas: Seedance 2.0 · Seedance 2.5 · Generador de vídeo IA · Guía de sincronía audio-vídeo · Qué es Seedance
¿Por qué «Seedance talking-head humano digital» es una búsqueda de alta frecuencia?
Un film de atmósfera puede no hablar; explicadores de curso, talking-head de producto, FAQ de soporte y afirmaciones de marca deben aterrizar «boca y palabras en el mismo pulso». El control a nivel de dirección de Seedance 2.0, las referencias multimodales y la sincronía nativa audio-vídeo permiten escribir el talking-head como spec ejecutable: la misma cara, la misma línea de diálogo, la misma pista vocal—en vez de generar imagen primero y pegar VO a la fuerza en post. Convertir la intención de búsqueda en «lip-sync que se puede aceptar» mejora la tasa de paso del acabado bajo Seedance 2.0 / Seedance 2.5 más que gritar «el humano digital se ve real».
- Identidad fijable: rostro, pelo, vestuario y luz de escena tienen puntos de control entre planos
- Diálogo divisible: una afirmación se parte en frases cortas rodables, para que una lectura de un solo aliento no emborrone los labios
- Ruta de upgrade clara: fija primero una plantilla talking-head de 6–10 s en 2.0 y evalúa Seedance 2.5 para diálogo continuo más largo
Acabado talking-head vs film de atmósfera solo audio-sync: no reutilices los mismos prompts
La sincronía audio-vídeo puede servir a pasos, unboxing y ruido de ambiente; el talking-head aún debe gestionar «forma de labios, acento, pausas y zona segura de subtítulos». Añadir «pon VO» a un prompt de film de atmósfera suele fallar con una boca casi quieta, o labios medio pulso por delante del audio. La escritura general de sincronía está en la guía de sincronía audio-vídeo; este artículo solo cubre diálogo a cámara.
- Rostro primero: fija la referencia de identidad antes de escribir el diálogo; no cambies de cara en cada línea
- Frases cortas: una o dos oraciones por plano, con medio pulso de respiración dentro de la línea para que los labios aterricen
- Cámara estable: el héroe talking-head usa un medio primer plano fijo o con micro-empuje; evita latigazos violentos que rompan la forma de labios
- Aire para subtítulos: deja el pecho y el tercio inferior libres para captions; no dejes que los gestos tapen la boca
Seedance 2.0 talking-head: tres capas de escritura
Capa 1: anclas de rostro y escena (obligatorio)
Abre cada prompt repitiendo los mismos identificadores: peinado y color de pelo, rasgos y franja de edad, vestuario, dirección de la luz clave, pared/escritorio de fondo. Sin líneas de ancla, Seedance 2.0 puede entregar «parece este tipo de presentador, pero una cara nueva en cada línea». Escribe el retrato de referencia como prefijo copiable. Para sujetar el look entre planos, usa la guía de coherencia de personaje.
Capa 2: deber del diálogo y ritmo de lip-sync (muy recomendado)
- Indica el deber de este plano: establecimiento de saludo / una afirmación / mención de producto / llamada a la acción (una línea primaria solo)
- Escribe el ritmo del diálogo: marca pausas, palabras de acento y si miran a cámara; no apiles un discurso largo en el mismo plano
- Que la cámara sirva a los labios: el héroe se queda en medio primer plano fijo, corta a un close-up de producto y vuelve a la misma cara (detalle de cámara en la guía de movimiento de cámara)
Capa 3: pista vocal y specs de entrega (imprescindible en talking-head)
Fija una pista vocal limpia para todo el talking-head (se permite una cama muy ligera) y no cambies de reverberación en cada línea. La sincronía nativa audio-vídeo de Seedance encaja la apertura/cierre de labios con las sílabas; si necesitas acentos de ambiente, añade solo SFX cortos y nunca cubras la voz. Unifica también el formato (16:9 horizontal para explicadores; abre plantilla aparte para feeds verticales), 4–8 s por plano, para poder hacer QA de lip-sync línea a línea.
Un flujo talking-head Seedance repetible (6 pasos)
- Escribe el guion talking-head: unas 12–18 caracteres chinos por línea (o la frase corta equivalente en tu idioma), un punto de información por línea
- Congela el prefijo de ancla de rostro (referencia de retrato + pelo y vestuario + luz de escena); todos los planos lo comparten
- Pasa el boceto talking-head de la primera línea en Seedance 2.0 (o Fast) y confirma apertura/cierre de labios
- Genera línea a línea: cambia solo «texto de diálogo + microexpresión» por plano, nunca la cara ni la escena
- Revisa contra la lista de aceptación de lip-sync: ¿apertura/cierre sigue sílabas, hay cambio de cara, la banda de subtítulos tapa la boca?
- Cuando la plantilla esté estable, lotea FAQ; pasa a Seedance 2.5 cuando necesites diálogo continuo más largo
Lista de aceptación del acabado talking-head
- ¿Sigue siendo la misma cara (pelo, sensación de edad, maquillaje sin saltos)?
- ¿La apertura/cierre de labios sincroniza con las palabras de acento, sin boca vacía obvia ni retraso?
- ¿Los ojos miran a cámara la mayor parte del tiempo, en vez de derivar a un punto irrelevante fuera de cuadro?
- ¿La voz es clara e inteligible, sin que la cama cubra el diálogo?
- Al cortar a un close-up de producto y volver, ¿sigue siendo el mismo presentador y la misma luz de escena?
Cuatro plantillas talking-head Seedance 2.0 de alto rendimiento
- Apertura de curso: «Mismo instructor de pelo negro, jersey beige, escritorio claro; medio primer plano mirando a cámara diciendo “hoy solo cubrimos una fórmula”; cámara fija con micro-empuje, voz clara, cama ligera, horizontal 16:9, 6 s.»
- Mención talking-head de producto: «Mismos auriculares plateados entran a cuadro; el presentador a cámara dice el nombre de marca, corte a close-up de producto, luego vuelta a la misma cara; luz comercial cálida, ident corto, el vertical puede ser una salida aparte.»
- FAQ de soporte: «Mismo look de soporte, auriculares y credencial; una pregunta, una respuesta, medio pulso en medio; plano medio fijo, sin expresión exagerada, fácil de intercambiar diálogo por lote.»
- Cierre de afirmación de marca: «Mismo presentador junto a la ventana; cuadro vacío medio segundo, luego entra y dice el eslogan, labios aterrizando en la última palabra; acento ligero de ident sónico, horizontal, 5–7 s.»
¿Cómo elegir estrategia talking-head según el escenario?
- Formación/curso: fija el rostro y rueda línea a línea; el B-roll de capítulos puede conectar con la guía para creadores de YouTube
- Venta talking-head ecommerce: congela anclas de producto y el rostro por separado; conecta con la guía de vídeo de producto ecommerce
- Talking-head de afirmación de marca: pon el eslogan solo en el plano de cierre, habla menos al inicio; estructura del héroe en la guía de comercial de marca
- Necesitas una toma de diálogo continuo más larga: prueba el lip-sync de una sola línea en 2.0 y evalúa Seedance 2.5 para reducir la sensación de corte y empalme
¿Cuándo el diálogo talking-head largo necesita Seedance 2.5?
La mayoría de líneas sueltas de 4–8 s, lotes de FAQ y aperturas de curso encajan mejor en Seedance 2.0 (incluidos tests de lip-sync con Fast e intercambio de frases por lote con Mini). Mueve una plantilla talking-head validada a Seedance 2.5 cuando necesites un discurso continuo de cerca de 15–30 s, referencias multimodales en paralelo (retrato + audio de referencia talking-head + escena), o menos coste de «cortar cada línea → realinear labios».
- Un solo pase necesita diálogo continuo más largo, sin corte que cambie de cara a mitad de toma
- Un héroe explicador constreñido a la vez por estilo de imagen + referencia vocal + precisión de lip-sync
- Un héroe de marca/curso que exige mayor resolución y menos puntos de corte visibles
Las diferencias de versión están en la comparación 2.0 vs 2.5 y la página de producto Seedance 2.5. Regla: prueba primero anclas de rostro y lip-sync de una sola línea en 2.0, luego sube por duración y continuidad—no gastes 2.5 en cada experimento talking-head.
Fallos habituales de talking-head
- Sin anclas de rostro, reescribir el aspecto en cada línea provoca cambios de cara
- Meter un discurso entero en un plano, de modo que los labios no siguen las sílabas
- Movimientos de cámara violentos o cortes frecuentes a close-up que interrumpen la forma de labios
- Cama demasiado alta, reverberación demasiado pesada, no se oye el diálogo y el QA de labios es más difícil
- Añadir «pon VO» a un prompt de film de atmósfera, de modo que la boca apenas se mueve
Lecturas adicionales
- Flujo para principiantes: Cómo usar Seedance 2.0
- Profundidad de prompts: Guía de ingeniería de prompts
- Texto a vídeo para planos de diálogo: Guía texto a vídeo
- Imagen a vídeo para retratos: Guía de imagen a vídeo
Conclusión
Usar Seedance 2.0 en talking-head y humanos digitales no es «una cara más parecida a una celebridad», sino una línea de producción de diálogo reutilizable: anclas de rostro congeladas, una línea por plano, lip-sync y acento que se pueden aceptar. Bloquea la plantilla talking-head de 6–10 s en Seedance 2.0 y pasa a Seedance 2.5 cuando haga falta un discurso continuo más largo. Cuando estés listo, abre Seedance 2.0 y empieza tu próximo talking-head IA desde una línea corta de diálogo.